Infrastructure Health
Host, Storage, Netzwerk und Ressourcen bilden die technische Basis – aber noch nicht die komplette Dienstsicht.
Monitoring bedeutet für mich nicht, möglichst viele grüne Kästchen auf einem Dashboard zu haben. Es soll mir helfen zu verstehen, was in einer Umgebung passiert – und möglichst früh erkennen lassen, wenn sich etwas in die falsche Richtung entwickelt. Ein laufender Prozess ist nicht automatisch ein gesunder Dienst. Und ein gesunder Dienst ist noch nicht automatisch aus Benutzersicht verfügbar.
Metriken zeigen Zustände, Logs liefern Kontext, Events markieren Veränderungen – erst gemeinsam entsteht ein belastbares Lagebild.
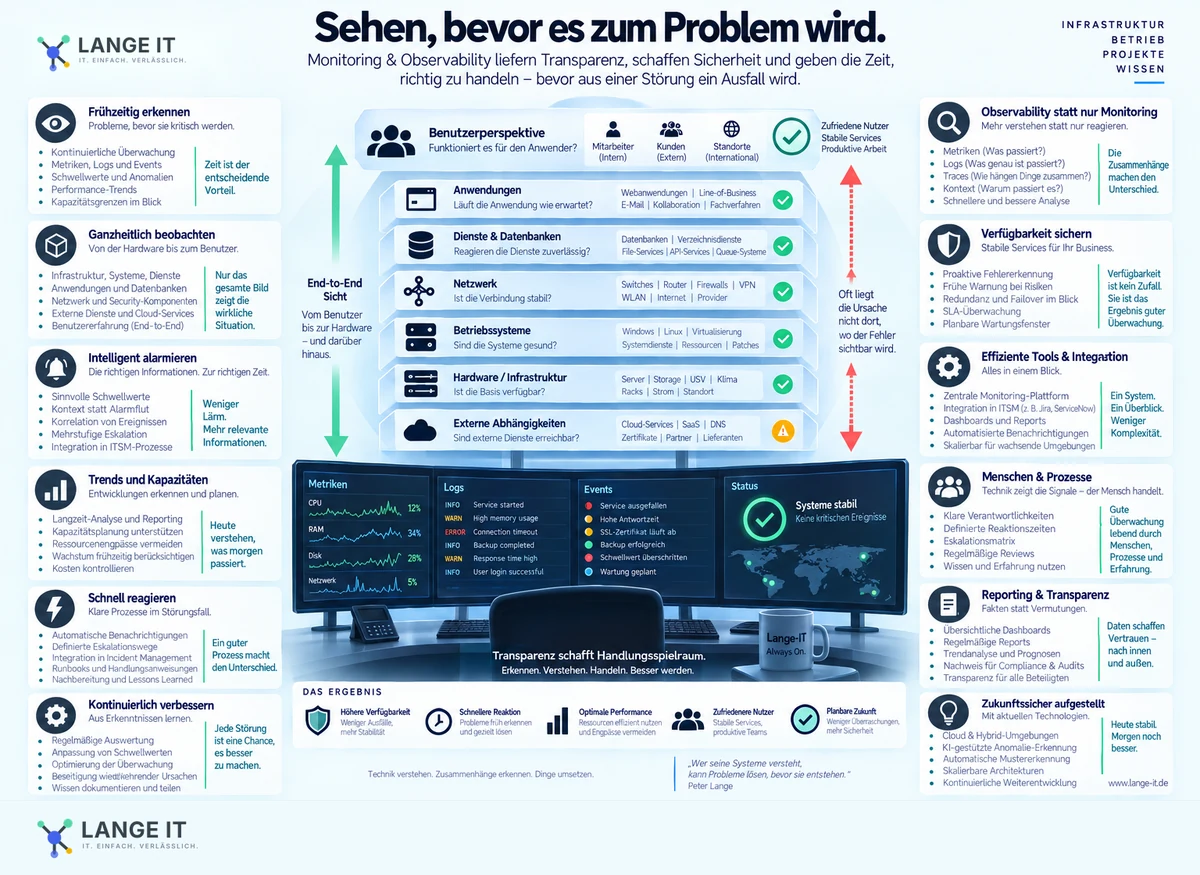
Monitoring wird dann wertvoll, wenn technische Signale in einen nachvollziehbaren Kontext gebracht werden.
Host, Storage, Netzwerk und Ressourcen bilden die technische Basis – aber noch nicht die komplette Dienstsicht.
Echte Healthchecks prüfen Abhängigkeiten und kritische Funktionen statt nur Prozesse oder Ports.
DNS, TLS, Routing und tatsächliche Erreichbarkeit aus einer anderen Fehlerdomäne betrachten.
Einzelereignisse erklären, Entwicklungen erkennen und Zustandswechsel korrelieren.
Priorität, Dauer, Abhängigkeiten und Auswirkungen bestimmen, wann ein Mensch wirklich reagieren muss.